

우수국제학술대회 34th International Symposium on the Modeling, Analysis, and Simulation of Computer and Telecommunication System (MASCOTS '26) 정규 발표 논문 채택
첨부파일

데이터 중심 AI 컴퓨팅 및 시스템 연구실 (DISCOS) 석사과정 장성 (제1저자/지도교수 김영재), 김영재 교수 (교신저자), 김기현 석박통합과정, 김진우 석박통합과정, 허민 석사과정 그리고 University of California, Merced의 Dong Li 교수와 함께 작성한 “PAVE: Partial KV Cache Eviction for Fine-Grained KV Reclamation in LLM Serving” 논문이 34th International Symposium on the Modeling, Analysis, and Simulation of Computer and Telecommunication System (MASCOTS '26)에 정규 논문(full paper)으로 게재가 확정되었다. 올해 MASCOTS '26 정규 논문의 채택률은 23%로, 본 연구는 치열한 경쟁을 뚫고 채택되는 성과를 거두었다.
최근 ChatGPT와 같은 생성형 AI 서비스가 빠르게 확산되면서, 수많은 사용자의 요청을 동시에 빠르게 처리하는 LLM Serving 기술의 중요성이 커지고 있다. LLM은 사용자가 지금까지 입력한 대화 내용을 KV 캐시(Key-Value Cache) 라는 형태로 GPU 메모리에 저장하여 이후 토큰을 생성할 때 반복 계산을 줄인다. 그러나 대화가 길어질수록 KV 캐시의 크기가 계속 증가하고, 여러 사용자가 동시에 서비스를 이용하면 GPU 메모리가 빠르게 부족해진다. 이를 방지하기 위해 기존 LLM 서빙 시스템은 실행 중인 요청을 일시적으로 중단하고 해당 요청의 KV 캐시를 GPU 메모리에서 전부 제거(Preemption)하는 방식을 사용한다.
하지만 기존 방식은 메모리가 조금만 부족한 상황에서도 요청이 가진 KV 캐시 전체를 제거한다는 한계를 갖는다. 실제로는 소량의 메모리만 확보하면 되는데도 전체를 삭제하기 때문에, 나중에 서비스를 다시 수행할 때 이미 계산했던 내용을 처음부터 다시 계산해야 한다. 이러한 불필요한 재계산은 응답 지연을 증가시키고 서비스 품질(Service Level Objective, SLO)을 저하시킨다. 기존 연구들은 언제 Preemption을 수행할지, 어떤 요청을 선택할지, 또는 삭제된 KV 캐시를 얼마나 빠르게 복원할지에 집중해 왔지만, 정작 ‘얼마나 많은 KV 캐시를 제거해야 하는가’라는 근본적인 문제는 다루지 못했다.
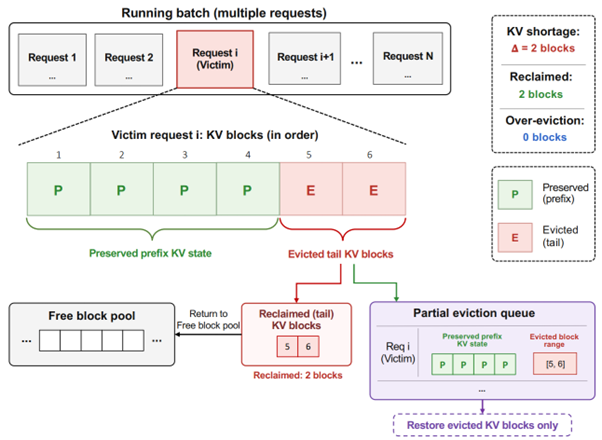
그림 1. PAVE의 Design Overview
본 연구는 이러한 문제를 Over-Eviction(과도한 KV 캐시 제거) 이라는 새로운 문제로 정의하였다. 즉, 기존 LLM 서빙 시스템은 실제 필요한 메모리보다 훨씬 많은 KV 캐시를 제거하면서 불필요한 재계산을 유발한다는 점에 주목하였다. 이를 해결하기 위해 본 연구에서는 PAVE(Partial KV Cache Eviction)를 제안하였다. PAVE는 요청 전체의 KV 캐시를 제거하는 대신, 현재 부족한 메모리를 확보하는 데 필요한 일부 KV 블록만 선택적으로 회수하는 새로운 메모리 관리 기법이다. 이후 요청이 다시 실행될 때에도 삭제된 일부만 복원하면 되므로 재계산량을 크게 줄일 수 있다. 또한 PAVE는 기존 LLM 서빙 시스템의 스케줄러나 연산 구조를 변경하지 않고, 메모리 회수 과정만 개선하기 때문에 기존 시스템에 쉽게 적용할 수 있다는 장점을 가진다.
실제 대화형 워크로드인 Azure Conversation와 합성 워크로드 등 다양한 실험 환경에서 평가한 결과, PAVE는 기존 방식에서 발생하던 과도한 KV 캐시 제거를 완전히 제거하였으며, 재계산이 필요한 구간의 평균 지연 시간을 300ms 이상에서 약 113ms까지 감소시켰다. 또한 사용자 체감 성능을 나타내는 토큰 생성 지연(TPOT)을 개선하여 서비스 품질(SLO) 만족률을 대표적인 LLM서빙 프레임워크인 vLLM 대비 최대 1.87배 향상시켰다. 이러한 결과는 PAVE가 기존 스케줄링 정책과 독립적으로 동작하면서도 다양한 LLM 서빙 시스템의 성능을 향상시킬 수 있음을 보여준다.
본 논문의 제1저자인 장성 석사과정은 "대학원 첫 학기에 기존 연구들이 해결하지 못한 부분을 풀어내어 학계에 기여할 수 있었다는 점에서 성취감과 연구의 매력을 느낄 수 있었습니다. 연구 과정에서 어려움도 있었지만, 끝까지 물심양면 지도해주신 김영재 교수님과 아낌없는 도움을 주신 김기현(석박통합과정) 선배, 김진우(석박통합과정) 선배, 허민(석사과정)께 진심으로 감사드립니다." 라고 소감을 전했다.
IEEE International Symposium on Modeling, Analysis, and Simulation of Computer and Telecommunication Systems (MASCOTS)는 컴퓨터 시스템 및 네트워크의 성능 분석을 주제로 하는 전통 있는 국제학술대회이다. 올해로 34회를 맞는 본 학회는 10월 20일부터 22일까지 이탈리아 제노바 University of Genoa에서 개최될 예정이다.
참고 자료:
- 34th International Symposium on the Modeling, Analysis, and Simulation of Computer and Telecommunication System (MASCOTS '26)
- Website : https://mascots26.iitis.pl/