

우수국제학술대회 Interspeech 2026정규 발표 논문 채택
첨부파일

지능형 연결 시스템 연구실(ICSL) [석사과정] [전우리], 소정민 교수(교신저자)가 음성인식 모델의 초저비트 양자화 정확도를 크게 끌어올린 논문 「Not All Frames Are Equal: Difference-Aware Quantization for Ultra-Low-Bit ASR」이 [interspeech 2026]에 정규 논문으로 게재가 확정되었다.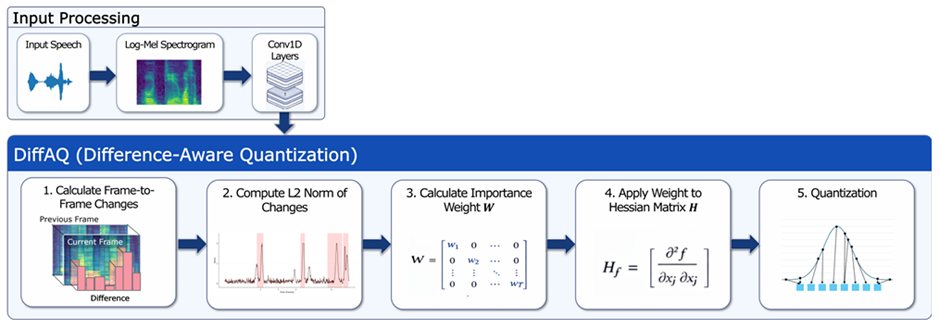
그림 1. 오디오 이벤트 추출 및 정제 과정
GPTQ, AWQ와 같은 사후 양자화(Post-Training Quantization) 기법은 대형 언어모델을 효과적으로 경량화하지만, 이를 자동음성인식(ASR) 모델에 2~3비트 수준으로 적용하면 인식 결과가 심각하게 무너지는 한계가 있었다. 음성 신호의 활성값은 정상 구간이나 무음 구간에서는 서로 강하게 중복되는 반면 음소가 바뀌는 경계에서는 급격히 변하는데, 기존 방식은 모든 프레임을 동일하게 취급하기 때문에 정보량이 적은 정적 구간이 보정(calibration) 과정을 지배하면서 정작 중요한 전이 구간이 가려지는 문제가 발생한다.
연구팀은 이를 해결하기 위해 프레임 간 활성값 차이로 음향 변화율을 측정하고, 그 값에 비례해 헤시안(Hessian) 중요도를 부여하는 DiffAQ를 제안했다. 제한된 양자화 정밀도를 음소적으로 중요한 프레임에 집중시키는 방식이다. DiffAQ는 별도의 재학습 없이 기존 GPTQ에 바로 적용할 수 있으며, 다양한 크기의 Whisper 모델과 표준 벤치마크에서 일관되게 단어 오류율(WER)을 낮췄다. 특히 기존 기법들이 정상적인 문장을 생성하지 못하고 붕괴하던 2비트 환경에서 가장 큰 성능 향상을 보였다.
[참고자료]
연구실: https://icslsogang.github.io/
학회링크: https://interspeech2026.org/en-AU