
최우수국제학술대회 NeurIPS 2026 정규 발표 논문 채택
컴퓨터공학과 김영재 교수 연구팀,
최우수국제학술대회 NeurIPS 2026 정규 발표 논문 채택
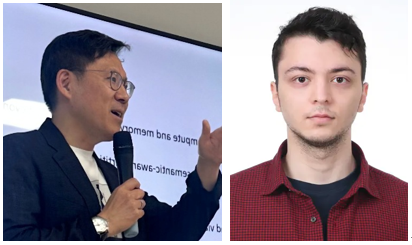
김영재 교수(컴퓨터공학과)와 Farid Talibli 박사과정 학생(컴퓨터공학과, 지도교수: 김영재 교수).
서강대학교 컴퓨터공학과 DISCOS (데이터 중심 AI 컴퓨팅 및 시스템) 연구실의 김영재 교수(교신저자)와 Farid Talibli 박사과정 학생(제1저자)은 Awais Khan, Christopher Zimmer (Oak Ridge National Laboratory), 박성용 교수, 양지훈 교수 공동저자와 함께 연구한 논문을 인공지능 분야 최우수국제학술대회인 NeurIPS 2026 (Acceptance Rate: 7,900/30,709 = 25.7%; 7,496 posters, 292 spotlights, and 112 orals)에 게재하게 되었다. 논문 제목은 “When Must AI Training Stage Checkpoints? A Distributional Model of Durability Boundaries at Scale”로, AI 학습 과정에서 체크포인트가 언제 실제로 안전하게 저장(durable)되는지를 분석하고, 적절한 스토리지 경로를 선택함으로써 장애 발생 시 롤백으로 인해 손실될 수 있는 학습 진행양을 줄이는 방법을 연구한다.
대규모 AI 모델을 학습하기 위해서는 장시간에 걸쳐 막대한 컴퓨팅 자원이 필요하다. 학습 진행 상황을 보존하기 위해 학습 시스템은 모델 파라미터, 옵티마이저 상태 및 장애 발생 후 연산을 재개하는 데 필요한 정보를 담은 체크포인트(checkpoint)를 주기적으로 저장한다. 비동기 체크포인팅(asynchronous checkpointing)을 사용하면 체크포인트 저장이 백그라운드에서 진행되는 동안에도 학습을 계속 수행할 수 있다. 그러나 학습 프로그램에 제어권이 반환되었다고 해서 최신 체크포인트가 즉시 장애 복구에 사용할 수 있는 안전한 상태로 저장되었다는 것을 의미하지는 않는다.
본 연구는 애플리케이션이 인식하는 체크포인트 완료 시점과 실제 학습 진행 상황이 안전하게 보호되는 시점 사이에 존재하는 이러한 차이에 주목한다. 필요한 체크포인트 데이터가 안전하게 저장되기 전에 장애가 발생하면, 학습은 더 오래된 체크포인트에서 다시 시작해야 하며 이미 수행한 연산을 반복해야 할 수 있다. 또한 공유 스토리지의 성능은 다른 워크로드와의 자원 경쟁에 따라 크게 변동할 수 있기 때문에, 이러한 위험에 노출되는 시간이 얼마나 지속될지를 사전에 예측하기도 어렵다.
또한 연구팀은 공유 파일시스템에 직접 체크포인트를 기록하는 방식과 파트너 노드의 로컬 스토리지에 복제하는 방식을 비교할 수 있는 조건부 기준을 제시하였다. 공유 스토리지의 부하가 낮은 상황에서는 파일시스템에 직접 기록하는 방식이 더 유리할 수 있지만, 공유 스토리지의 경합으로 인해 체크포인트 완료가 지연되는 상황에서는 파트너 노드로의 복제가 더 빠르게 데이터의 안전한 저장 시점(durable boundary)을 확보할 수 있다. 따라서 본 연구의 목적은 모든 상황에서 공유 파일시스템을 대체하는 것이 아니라, 어떤 상황에서 대체 스토리지 경로를 사용하는 것이 효과적인지를 판단하는 것이다.
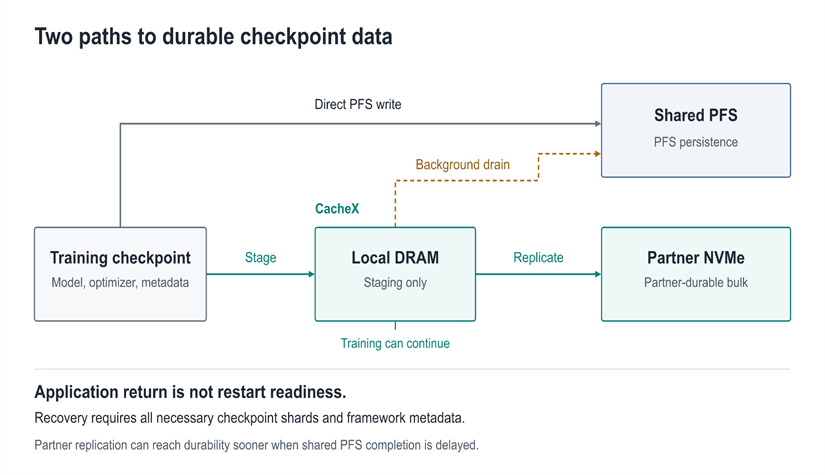
이를 구현하기 위해 연구팀은 PyTorch Distributed Checkpoint 하위에서 투명하게 동작하는 스토리지 계층인 CacheX를 개발하였다. CacheX는 체크포인트 데이터를 로컬 메모리에 우선 저장한 후 파트너 노드의 NVMe 스토리지에 복제하고, 이후 공유 파일시스템으로 데이터를 전송한다. 기존 파일 인터페이스를 그대로 사용하기 때문에 애플리케이션의 체크포인팅 코드를 변경하지 않고도 이러한 새로운 스토리지 경로를 사용할 수 있다.
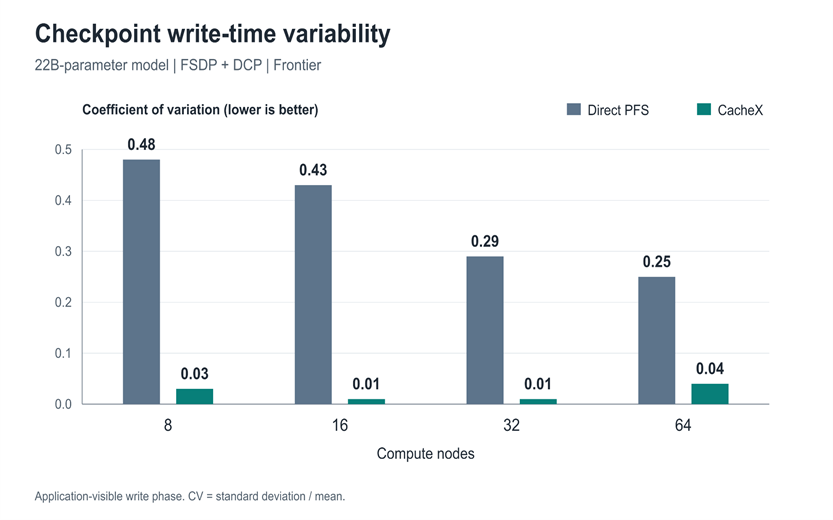
성능 평가는 미국의 Frontier 슈퍼컴퓨터, KISTI의 Neuron 시스템, 그리고 실제 분산 AI 학습에서 생성되는 체크포인트를 이용하여 수행하였다. 실험 결과, CacheX는 평가된 워크로드에서 체크포인트 쓰기 시간의 변동계수(coefficient of variation)를 최대 43배 감소시켜 보다 일관되고 안정적인 쓰기 성능을 제공하였다. 또한 별도의 검증 실험에서는 대규모 환경에서 일반적인 writer의 완료 시간을 평균 절대 백분율 오차(MAPE) 7.1%수준으로 예측하였다. 다만 이 예측 결과는 일반적인 완료 시간에 대한 것이며, 드물게 발생하는 극단적인 straggler를 사전에 예측하는 것을 의미하지는 않는다.
장애 주입(failure injection) 실험을 통해 실제 AI 학습 상태의 복구 가능성도 검증하였다. 연구팀은 체크포인트 메타데이터를 담당하는 호스트의 학습 프로세스를 강제로 종료하고, 해당 호스트의 로컬 CacheX 데이터를 삭제한 뒤, 공유 파일시스템을 이용한 fallback 기능까지 비활성화하였다. 이러한 상황에서도 생존 노드와 파트너 노드에 저장된 복제본을 통해 32개의 체크포인트 shard와 프레임워크 메타데이터 전체를 확보할 수 있었으며, 이를 이용해 모델과 옵티마이저 상태를 정상적으로 복원하고 AI 학습을 성공적으로 재개하였다.
본 연구는 체크포인트로 인한 학습 중단 시간을 줄이는 것과 이미 완료된 학습 진행 상황을 장애로부터 보호하는 것은 서로 연관되어 있지만 구별되어야 하는 문제임을 보여준다. 연구의 주요 기여는 체크포인트의 데이터 안전성 경계(durability boundary)를 이해하기 위한 분석 프레임워크, 상황에 따라 적절한 스토리지 경로를 선택하기 위한 모델, 그리고 실제 분산 AI 학습 환경에서 검증된 시스템을 함께 제시했다는 데 있다. 이를 통해 실제 대규모 AI 학습 시스템에서 체크포인팅 정책을 평가할 때 애플리케이션이 체감하는 성능뿐 아니라 장애 발생 시 손실될 수 있는 학습 진행량까지 함께 고려할 수 있는 방법을 제공한다.
참고자료
lNeurIPS(Conference on Neural Information Processing Systems)는 인공지능 및 머신러닝 분야를 대표하는 세계적인 국제 학술대회이다.
lNeurIPS 학회: https://neurips.cc/
l데이터 중심 AI 컴퓨팅 및 시스템 연구실 (DISCOS 연구실): https://discos.sogang.ac.kr