

자연어처리 분야 BK 등재 IF2 ‘NAACL 2024’에 논문 채택
Files

컴퓨터공학과 구명완 교수 연구팀,
자연어처리 분야 BK 등재 IF2 ‘NAACL 2024’에 논문 채택
▲ (왼쪽부터) 컴퓨터공학과 구명완 교수, 대학원 인공지능학과 김민주 석사과정생, 정해인 석사과정생
컴퓨터공학과 구명완 교수가 지도하는 지능형 음성대화 인터페이스(ISDS) 연구팀의 논문이 ‘2024 Annual Conference of the North American Chapter of the Association for Computational Linguistics’(이하 NAACL 2024)에서 ‘NAACL Findings Paper’로 채택되었다.
NAACL은 1998년부터 설립된 자연어처리 분야 최고 권위 학회 ACL의 북아메리카 학회로, ACL과 EMNLP와 함께 글로벌 3대 자연어처리(Natural Language Processing, NLP) 학회로 평가받는다. NAACL 2024는 오는 6월 16~21일 멕시코 수도 멕시코시티에서 개최될 예정이다.
대학원 인공지능학과 김민주·정해인 석사 과정생(공동 1저자)과 구명완 교수(교신저자)의 논문은 ‘SELF-EXPERTISE: Knowledge-based Instruction Dataset Augmentation for a Legal Expert Language Model’라는 제목으로 NAACL 2024의 논문집에 게재된다.
연구팀은 대규모 언어 모델(Large Language Model, LLM)을 사용하여 자동으로 명령어 데이터셋(Instruction Dataset)을 생성할 때 언어 모델이 가지고 있는 기본 지식만으로 생성할 경우 부정확하거나 그럴듯한 거짓 정보를 생성할 수 있는 환각 현상을 지적하였다. 특히, 법률과 같이 정확성이 중요한 전문 지식 분야에 대해서는 LLM이 정확한 정보를 생성하는 것을 더욱 어려워하는 점을 문제로 삼았다. 따라서 연구팀은 기존 LLM의 한계를 극복하고 법률 분야와 같이 정확성이 중요한 분야에서 전문가 수준의 지식을 반영한 명령어 데이터셋을 자동으로 생성하는 새로운 증강 파이프라인인 SELF-EXPERTISE를 제안하였다. 실제 선생님이 시험문제를 출제할 때 교과서에서 시험범위에 해당하는 내용을 참고해 시험문제를 만드는 것처럼, LLM이 지식을 참고해 명령어, 입력, 출력 쌍을 제작하도록 하여 환각 현상을 줄이고 정확도를 높였다.
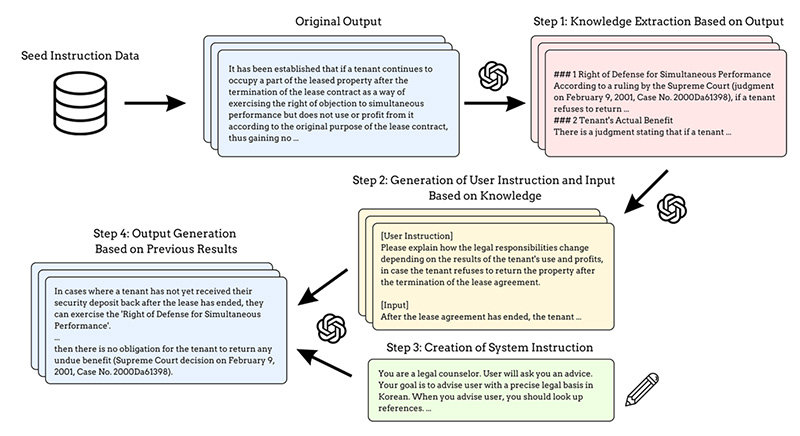 ▲ 연구팀이 논문에서 제안한 전문 분야 명령어 데이터셋 증강 파이프라인
연구팀은 SELF-EXPERTISE를 통해 생성된 법률 분야 명령어 데이터셋으로 LLaMA-2 7B 모델을 학습하여 법률 전문 모델 LxPERT를 개발하였으며, 이 모델은 기존의 GPT-3.5 모델을 포함한 다른 모델들보다 법률 분야에서 더 높은 성능을 달성하였다. 해당 연구는 정확한 지식 기반의 명령어 데이터셋 생성 방법이 LLM의 활용 범위를 전문 분야로 확장하는 데 중요한 역할을 할 수 있음을 보여준다.
이번 연구에 참여한 석사과정생들은 각각 스마일게이트가 후원하는 DHE(Digital Human Entertainment) 장학생, LG전자가 후원하는 Smart AI 장학생이다. 이들은 “석사 과정 동안 지속적으로 연구하였던 분야에서 뜻 깊은 성과를 이루어서 뿌듯하다”라며 “사람들의 삶에 도움이 될 수 있는 기술을 연구하여 사회에 기여하고 싶다”라고 소감을 밝혔다.
구명완 교수는 “앞으로도 더 많은 학생들이 좋은 결과를 얻을 수 있도록 지속적으로 관심을 가지고 지도하겠다”라고 말했다.