

NAVER AI RUSH 경진대회 자연어처리 분야 1등상 수상, 자연어처리 연구실 안휘진, 정영훈 석사과정생
첨부파일

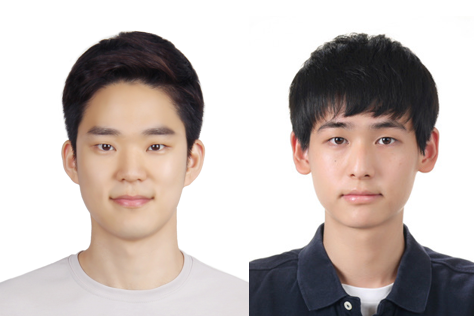
▲ (왼쪽부터) 컴퓨터공학과 안휘진 석사과정, 정영훈 석사과정
서강대학교 컴퓨터공학과 자연어처리 연구실 소속 대학원생 안휘진, 정영훈이 NAVER AI RUSH 경진대회에 참가해서 우수한 성적을 거두었다. NAVER AI RUSH는 네이버가 주최한 인공지능 모델링 경진대회로, 참가자들은 자연어처리와 이미지분석, 음성인식 등 다양한 분야의 과제를 풀어야했다. 안휘진, 정영훈 학생은 자연어처리 분야 스팸 메일 분류 문제에서 1등을, 문법 교정 문제에서 3등을 하여 총 상금 1,800만원과 NAVER 입사시 서류 및 실기 시험이 면제되는 혜택을 받게 되었다.
유독 이 학생들의 수상에 눈길을 끄는 까닭은 두 학생의 남다른 배경때문이다. 두 학생의 학부 1전공은 각각 서강대학교 미국문화학, 중국문화학으로 공대가 아닌 인문학부 출신이다. 컴퓨터 공학을 전공하지 않는 학생에게도 다양한 기회를 주는 서강대학교의 분위기 덕에 두 학생은 컴퓨터 공학의 기초를 익힐 수 있었다고 한다. 안휘진 학생은 학부 마지막 학년 때 컴퓨터 공학에 관심을 갖게 되어 관련 과목을 수강하였고, 정영훈 학생은 조금 더 일찍 흥미를 발견하고 관련 과목을 수강하여 복수 전공까지 할 수 있었다고 한다.
"연구실 생활을 하며 자연어처리의 기본을 비롯해 연구 프로젝트까지 경험해볼 수 있었는데, 이번 경진대회를 통해 실전 문제도 도전해보고 싶었습니다." 안휘진 학생이 AI RUSH에 참가하게 된 동기를 밝혔다. 올 해 AI RUSH 대회는 실제 네이버에서 수집한 대용량 데이터를 바탕으로 이루어졌다. "현실 데이터를 마주하니 제약사항은 많았지만, 내가 만든 인공지능 시스템이 실제 서비스에도 적용될 수 있다는 것이 큰 동기부여가 되었습니다” 라고 정영훈 학생은 말했다.
이들은 스팸 메일 분류 문제를 해결하기 위해 CNN, RNN, Transformer 기반의 앙상블 모델을 고안하였다. 또한 데이터 불균형 문제를 해결하기 위해 가중치 기반 샘플링 기법을 활용하였다. 문법 교정 문제에선 양이 적은 데이터를 극복하기 위하여 backtranslation 기반의 데이터 augmentation 기법을 활용하였다. 또한, subword기반 정규화 방법을 사용하여 보다 범용적인 모델을 구축하였다.
참고자료
Grammar Error Correction task 후기(안휘진)
Spam Mail Detection task 후기(정영훈)
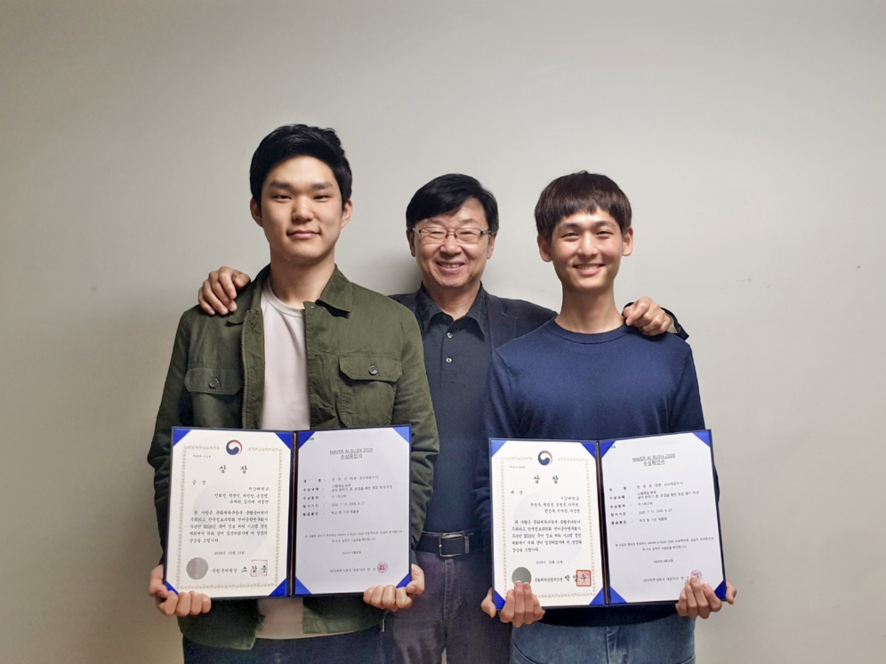
▲ (왼쪽부터) 컴퓨터공학과 안휘진 석사과정, 지도교수 서정연 교수, 정영훈 석사과정
연관 기사 바로가기 >>> Click