

우수국제학술대회 ACM SAC (Operating Systems Track) 정규 발표 논문 채택
첨부파일

우수국제학술대회 ACM SAC (Operating Systems Track) 정규 발표 논문 채택
(제1저자: 이진훈, 책임저자: 김영재 교수)
▲ (왼쪽부터) 이진훈(석사과정), 정연우(박사과정),
(아래 왼쪽부터) 사프달 자밀(석박통합과정), 김영재(책임저자)
컴퓨터공학과 대학원 이진훈 학생(석사과정 4학기, 지도교수: 김영재), 정연우 학생(박사과정 6학기, 지도교수: 박성용), 사프달 자밀(석박통합과정 10학기, 지도교수: 김영재)이 컴퓨터공학과 김영재 교수(책임저자)의 지도를 받아 작성한 "MFence: Defending Against Memory Access Interference in a Disaggregated Cloud Memory Platform" 라는 제목의 논문이 BK21 플러스 사업 Computer Science 분야 우수국제학술대회 리스트에 보정 IF=1로 등재된 ACM/SIGAPP Symposium On Applied Computing - Operating Systems Track에 게재가 확정되었다. 본 논문에서는 VM 기반 분산 클라우드 메모리 플랫폼 환경에서 프로세스 간 공유 캐시의 불공평한 메모리 점유 문제를 해결하기 위해 캐시 파티셔닝 매커니즘인 MFence를 제안하였다. MFence는 독립적으로 분할된 캐시 영역을 지원하는 커널 모듈로 프로세스 간의 캐시 간섭을 완전히 제거한다.
VM 기반 분산 클라우드 메모리 플랫폼 환경은 두 개 이상의 노드가 서로의 메모리를 빌리거나, 빌려줄 수 있는 아키텍쳐로, 메모리의 이용량과 수용량을 늘려 응용 프로그램의 성능을 향상시키는 아키텍쳐이다. 위 아키텍쳐는 특정 노드에서 로컬 메모리를 캐시처럼 사용하고, 외부 노드를 스왑 (OS Swap) 공간처럼 이용하기 때문에, 로컬 메모리 내부에서 캐시 경쟁 현상이 발생한다. 본 논문에서는 Hypercall 과 gCR3의 두 방식을 이용하여 캐시 경쟁 현상을 방지하는 아키텍쳐인 MFence를 제안하였다.
MFence는 낮은 오버헤드로 공정한 캐시 파티셔닝을 가능하게 하고 성능 향상을 가져옴을 증명하였다. 대표적인 예로 Aggregation 워크로드 및 Grep 워크로드가 동시에 실행되는 상황에 대해, MFence를 통한 캐시 파티셔닝을 수행하였을때 14.4% 성능 향상을 보였다.
그림 1. 본 논문에서 제시하는 시스템의 자료구조 및 플로우 차트 |
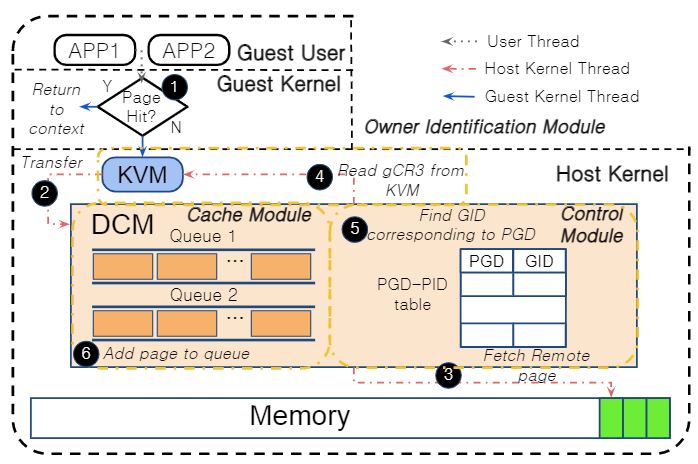
그림 1은 MFence 의 gCR3 방식에 대한 자료구조 및 플로우 차트를 설명한 그림이다. MFence는 Cache Module, Owner Identification Module, Control Module의 세 가지의 모듈의 상호작용을 통해 동작한다. 먼저 유저는 로컬 캐시 파티셔닝을 위해 API를 이용하여 Control Module에게 명령어를 전달한다. 해당 명령어를 받은 Cache Module은 로컬 캐시 공간에 대응되는 큐를 새로 할당한 후 그에 대응하는 고유한 그룹 ID를 할당한다. 또한 응용를 캐시 공간에 맵핑시켜, 특정 응용이 지정된 크기의 캐시 공간을 사용하게 한다.
위의 전처리 이후에, 응용 프로그램에서 페이지 폴트가 발생시, 외부 노드에서 폴트가 발생한 페이지를 가져온 뒤, 해당 페이지의 소유 응용을 Owner Identification Module을 통해 알아내고, 알맞은 큐에 삽입을 시키는 흐름으로 진행된다.
ACM/SIGAPP SAC 컨퍼런스는 다양한 컴퓨팅 분야를 위한 저명한 국제학술대회이다. 본 학회는 내년 에스토니아의 탈린에서 3월 27일부터 31일까지 진행될 예정이다.
참고자료
ACM/SIGAPP SAC 학회 사이트: https://sigapp.org/sac/sac2023/
MFence: Defending Against Memory Access Interference in a Disaggregated Cloud Memory Platform 논문: https://discos.sogang.ac.kr/file/2023/intl_conf/SAC_2023_J_Lee.pdf