

우수국제학술대회 IEEE International Conference on Cloud Computing (CLOUD) 2026 정규 발표 논문 채택
첨부파일

데이터 중심 AI 컴퓨팅 및 시스템 연구실(DISCOS)의 박사과정 박규리(제1저자), 석사과정 윤성민, Awais Khan 박사, 박성용 교수(교신저자), 김영재 교수(교신저자)가 작성한 “CODA: Breaking CPU Bottlenecks for Scalable Ceph with DPU-Based OSD Decoupling” 논문이 IEEE International Conference on Cloud Computing (IEEE CLOUD) 2026에 게재가 확정되었다.
최근 클라우드 인프라는 대규모 데이터센터를 넘어 엣지 클라우드와 소규모 클러스터로 확장되고 있으며, 제한된 CPU 자원 안에서 고성능 스토리지를 운영하는 것이 중요한 과제가 되고 있다. 최신 NVMe SSD는 수 GB/s급 대역폭을 제공하지만, 분산 스토리지 시스템에서는 저장장치보다 이를 처리하는 소프트웨어 스택과 CPU가 새로운 병목으로 부각되고 있다.
본 연구는 대표적인 분산 스토리지 시스템인 Ceph에서 OSD(Object Storage Daemon)의 CPU 병목을 분석하였다. 분석 결과, 실제 디스크 I/O를 담당하는 BlueStore보다 Messenger와 OSD Core에서 수행되는 메시지 처리, 복제 조정, 트랜잭션 처리 비용이 CPU 사용량의 대부분을 차지하는 것으로 나타났다. 특히 OSD 수가 증가할수록 이러한 application-level 처리 비용이 누적되어 host CPU가 빠르게 포화되고, 결과적으로 NVMe SSD의 성능을 충분히 활용하지 못하는 문제가 발생한다.
이를 해결하기 위해 본 연구는 Ceph OSD Decoupling Architecture인 CODA를 제안한다. CODA는 Ceph OSD를 DPU에서 실행되는 front-end path와 host에 유지되는 persistence backend로 분리한다. 즉, CPU 사용량이 큰 Messenger와 OSD Core는 DPU로 오프로드하고, 실제 NVMe 장치와 직접 연결된 BlueStore는 host에 유지함으로써 host CPU가 저장장치 I/O에 집중할 수 있도록 한다.
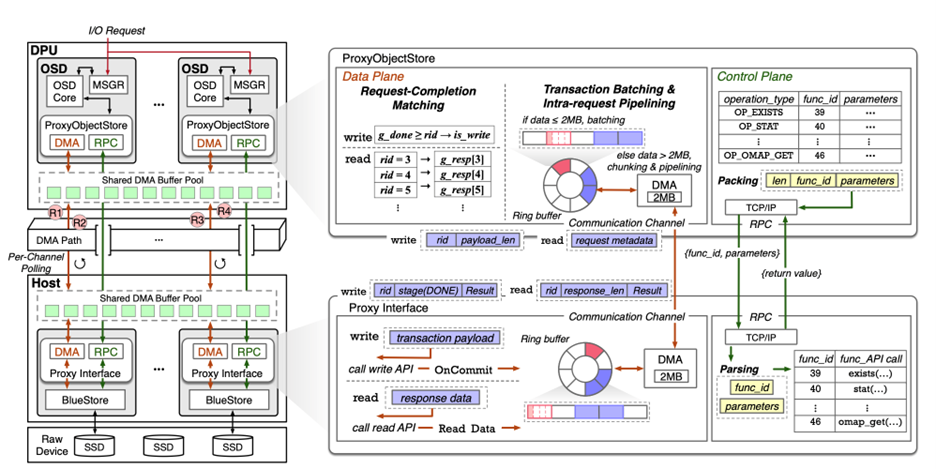
[그림1: CODA의 아키텍처 오버뷰]
CODA는 OSD 분리 구조를 실현하기 위해 세 가지 핵심 기법을 설계하였다. 첫째, Flow-Direct는 DPU와 host 사이의 cross-boundary transaction path를 제공한다. DPU 측 ProxyObjectStore가 OSD의 backend 호출을 가로채고, bulk I/O는 DMA 기반 data plane으로, metadata 및 control operation은 lightweight RPC 기반 control plane으로 전달한다. 둘째, Flow-Adapt는 DPU-host DMA 전송의 고정 비용과 2MB 전송 크기 제한을 완화한다. 작은 transaction은 batching하여 한 번의 DMA로 묶어 전송하고, 큰 request는 chunking 및 intra-request pipelining을 적용하여 DMA 제약으로 인한 성능 저하를 줄인다. 셋째, Flow-Sync는 여러 OSD가 동시에 동작할 때 증가하는 completion handling 및 synchronization 비용을 줄이기 위해 per-channel polling과 lock-free request-completion matching을 적용한다.
대표적인 실험 결과로 CODA는 NVIDIA BlueField-3 DPU가 장착된 Ceph 클러스터에서 host CPU 사용량을 최대 88%까지 감소시켰다. 또한 no-replication 환경에서는 기존 Ceph 대비 최대 49%의 처리량 향상을 달성하였고, 3-way replication 환경에서는 최대 94%의 처리량 향상을 보였다. OSD 수가 8개로 증가한 환경에서도 all-CODA 구성은 기존 all-baseline 구성 대비 37% 높은 처리량을 달성하였으며, host OSD와 DPU OSD를 함께 사용하는 hybrid placement 구성에서는 최대 71%의 처리량 향상을 확인하였다.
본 연구는 DPU를 단순한 네트워크 가속기가 아니라, 분산 스토리지 시스템의 application-level execution path를 수행하는 독립적인 실행 플랫폼으로 활용했다는 점에서 의미가 크다. 특히 CODA는 Ceph의 기존 일관성 및 복제 semantics를 유지하면서도, CPU 병목이 집중되는 OSD front-end logic을 DPU로 분리함으로써 host CPU 자원을 효과적으로 절감하였다. 이는 고속 NVMe SSD 시대에 분산 스토리지 시스템의 성능 한계가 저장장치가 아니라 소프트웨어 경로와 CPU 자원 관리에 있음을 보여주며, 향후 DPU 기반 차세대 스토리지 시스템 설계의 중요한 방향을 제시한다.
논문의 제1저자인 박규리 박사과정은 “최신 NVMe SSD의 성능을 충분히 활용하기 위해서는 단순히 더 빠른 장치를 도입하는 것뿐 아니라, 스토리지 소프트웨어 스택이 CPU를 어떻게 사용하는지 정밀하게 분석하고 재구성하는 것이 중요하다고 생각합니다. 이번 연구에서는 Ceph OSD의 병목을 application-level logic 관점에서 분석하고, 이를 DPU 기반 분리 실행 구조로 해결하고자 했습니다. 함께 연구를 진행한 공동 연구자분들과 지도교수님들께 감사드립니다.”라고 소감을 전했다.
EEE International Conference on Cloud Computing(IEEE CLOUD)은 IEEE World Congress on SERVICES의 주요 학회 중 하나로, 클라우드 컴퓨팅, 분산 시스템, 클라우드 인프라 및 서비스 컴퓨팅 분야의 최신 연구 성과를 공유하는 국제 학술대회이다. 본 논문은 2026년 7월 13일부터 18일까지 호주 시드니에서 개최되는 2026 IEEE World Congress on SERVICES(SERVICES 2026)에서 발표될 예정이다.