

우수국제학술대회 The 40th International Conference on Massive Storage Systems and Technology (MSST 2026) 정규 발표 논문 채택
첨부파일

데이터 중심 AI 컴퓨팅 및 시스템 연구실 (DISCOS) 박사과정 황순 (제1저자), 김영재 교수 (교신저자)가 SK Hynix 메모리 시스템 연구소 연구팀 (노정기 팀장, 정우석 담당)과 작성한 “Scout-and-Reduce: Budget-Aware Storage-Side Reduction for Memory-Safe GPU Analytics” 논문이 The 40th International Conference on Massive Storage Systems and Technology (MSST 2026)에 정규 논문(full paper)으로 게재가 확정되었다.
GPU는 cuDF와 같은 GPU 데이터프레임 라이브러리를 통해 대화형 표 형식 데이터 분석을 빠르게 처리할 수 있어, 노트북 환경에서 object storage에 저장된 Parquet 데이터를 직접 분석하는 워크플로우의 핵심 가속기로 활용되고 있다. 그러나 이러한 직접 처리 경로(direct path)는 “조금만 데이터가 커져도 갑자기 GPU 메모리가 터져서 작업이 완전히 실패하는 현상, GPU Memory cliff을 드러낸다. 이는 어떤 입력 크기에서는 정상 완료되던 작업이 더 큰 규모에서는 별다른 전조 없이 out-of-memory(OOM) 오류로 실패하는 것이다. 특히 Parquet은 컬럼 인코딩과 페이지 압축을 사용하기 때문에 디코딩 후 메모리 사용량이 디스크 크기보다 훨씬 커, 파일 크기만으로는 OOM을 예측하기 어렵다.
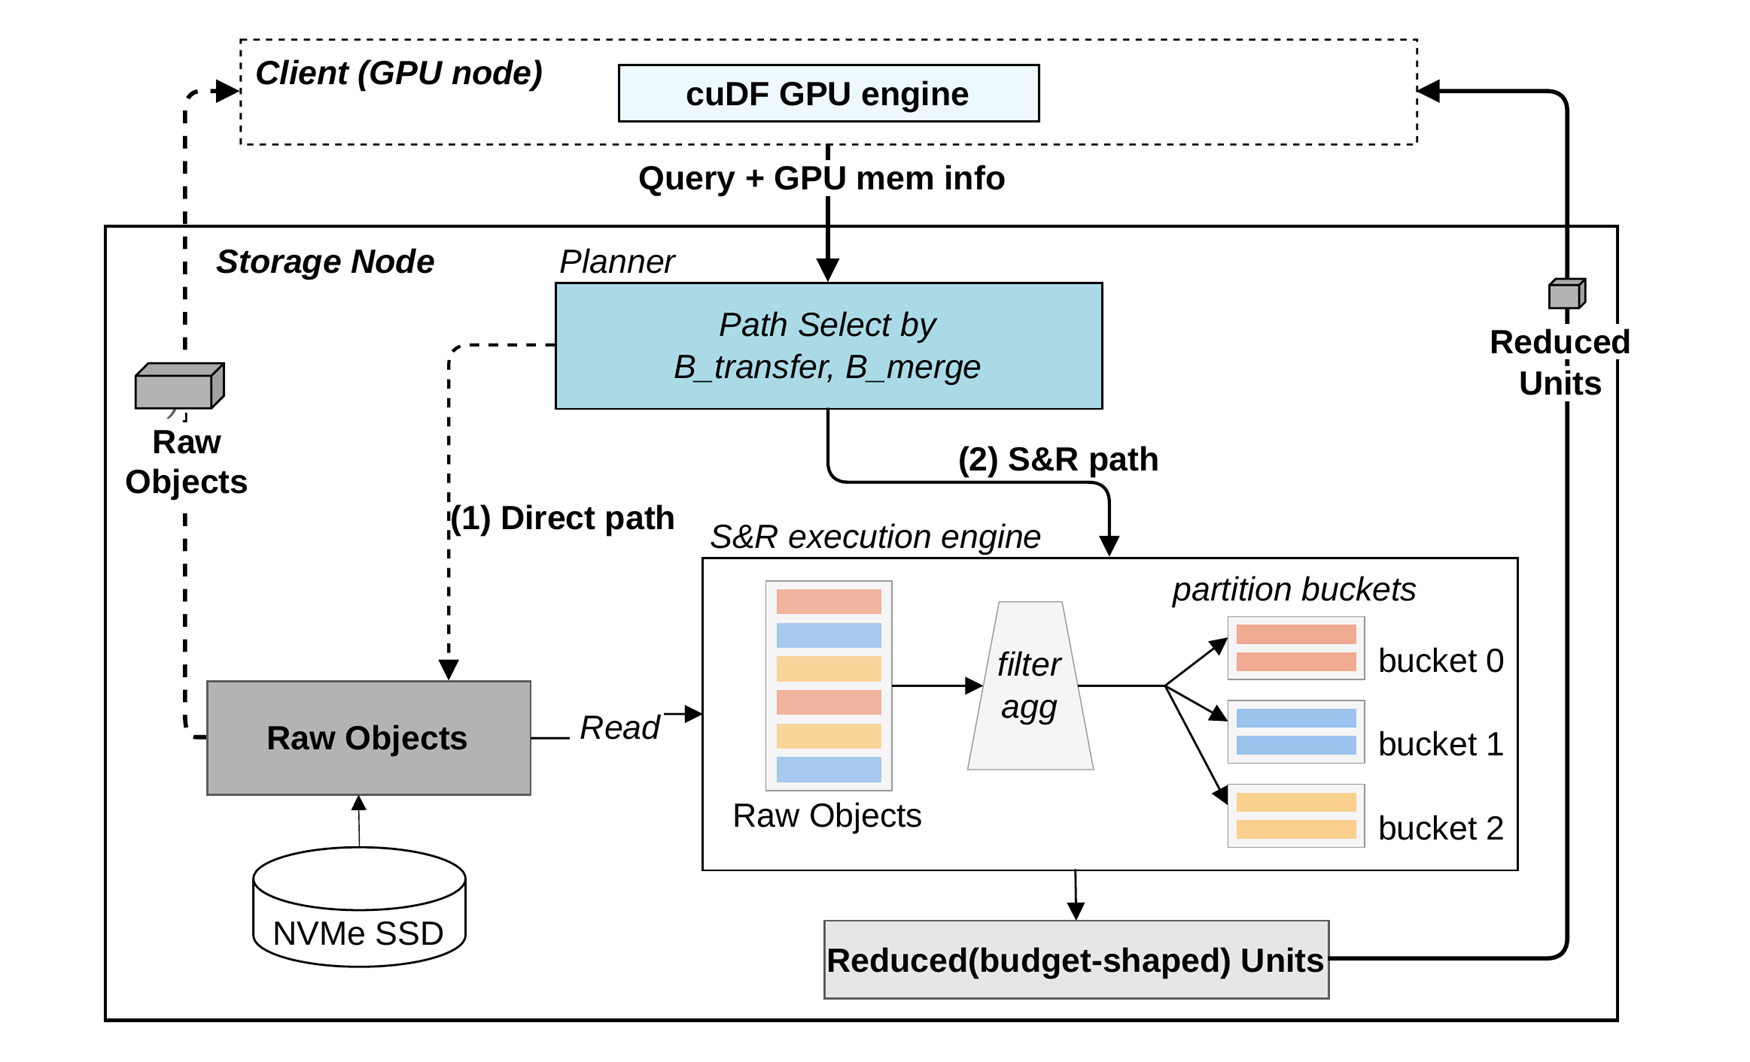 그림 1. Scout-and-Reduce(S&R)의 architecture overview
본 연구는 GPU 분석의 메모리 안전성을 좌우하는 두 가지 예산(budget)에 주목하였다. 첫째는 한 단계에서 GPU에 올라오는 전송 단위의 디코딩 크기를 의미하는 Btransfer, 둘째는 group-by 집계 과정에서 GPU가 유지해야 하는 중간 해시 테이블 상태의 크기를 의미하는 Bmerge이다. 기존의 스토리지 측 오프로딩(offloading) 기법들은 전송되는 바이트 수를 줄이는 데에만 초점을 맞추어, 두 예산 중 어느 것도 제대로 제어하지 못한다는 한계가 있었다. 본 연구는 object storage가 단순히 바이트를 전달하는 데 그치지 않고, GPU의 메모리 용량에 맞춰 미리 가공된 단위를 내보내야 한다는 문제의식에서 출발하였다.
이러한 문제의식에서 출발하여 본 연구에서는 Scout-and-Reduce(S&R)를 제안하였다. S&R은 스토리지 서버에 함께 배치되는 sidecar와 GPU 클라이언트로 구성되며, 클라이언트가 질의와 함께 GPU 메모리 정보를 전달하면 sidecar의 2단계 planner가 동작한다. planner는 Parquet 파일의 footer 메타데이터만을 읽어 데이터 페이지를 전혀 읽지 않고도 디코딩 후 GPU 메모리 사용량을 추정하고, 작업이 GPU 용량 안에 들어오면 직접 경로를, 그렇지 않으면 스토리지 측에서 정확한 지역 축약(exact local reduction)을 수행하는 S&R 경로를 선택한다. 특히 high-cardinality group-by의 경우 결과를 키가 서로 겹치지 않는 버킷(key-disjoint bucket)으로 분할하여, GPU가 한 번에 하나의 버킷만 병합하도록 함으로써 중간 상태가 장치 용량을 초과하지 않도록 보장한다. 데이터 자체의 의미를 보존하면서 스토리지-클라이언트 인터페이스를 재정의했다는 점이 핵심이다.
4GB GPU(NVIDIA RTX A400) 환경에서 NYC Yellow Taxi와 OTTO recommendation events 두 실제 데이터셋으로 평가한 결과, 직접 경로와 필터 오프로딩이 OOM으로 실패하는 모든 규모에서 S&R은 작업을 끝까지 완료하였다. footer 기반 추정기는 실제 디코딩 크기를 평균 1.8% 오차 이내로 예측하였으며, S&R은 데이터 규모와 무관하게 peak GPU 메모리를 장치 한계보다 충분히 낮게 유지하였다. 또한 이 모든 과정은 별도의 전용 하드웨어 없이 기존 스토리지 서버의 CPU와 메모리 자원만으로 수행되어 범용성을 입증하였다.
본 논문의 제1저자인 황순 박사과정은 “GPU 메모리 한계 때문에 분석 작업이 갑자기 실패하는 문제는 흔히 마주칠 수 있지만 정작 깊이 다뤄지지 않은 주제였습니다. 스토리지 단에서 데이터를 GPU의 메모리 예산에 맞춰 미리 가공한다는 관점이 이 문제를 푸는 새로운 방향이 될 수 있다고 생각합니다. 지도해 주신 김영재 교수님과 함께 연구해 주신 SK하이닉스 연구진께 감사드립니다.” 라고 소감을 전했다.
The International Conference on Massive Storage Systems and Technology (MSST)는 1974년 창설 이후 대규모 스토리지 시스템의 설계자, 아키텍트, 연구자, 산업계 전문가가 모여 파일 및 스토리지 시스템의 최신 연구 성과와 과제를 공유해 온 권위 있는 국제 학술대회이다. 본 학회는 올해 6월 1일부터 5일까지 미국 실리콘밸리의 산타클라라 대학교(Santa Clara University)에서 개최되며, 동료 평가를 거친 정규 연구 논문은 연구 트랙(6월 4–5일)에서 발표될 예정이다.
참고 자료:
- The 40th International Conference on Massive Storage Systems and Technology (MSST 2026)
- Website : https://www.msstconference.org/