

우수국제학술대회 Interspeech 2026정규 발표 논문 채택
첨부파일

지능형 컴퓨터 아키텍쳐 및 임베디드 컴퓨팅 연구실 (ECL) 박사과정 이태한 (제1저자), 석사과정 정재한, 이혁준 교수 (교신저자)가 작성한 논문 「SAM: A Mamba-2 State-Space Audio-Language Model」 이 Interspeech 2026에 정규 논문으로 게재가 확정되었다.
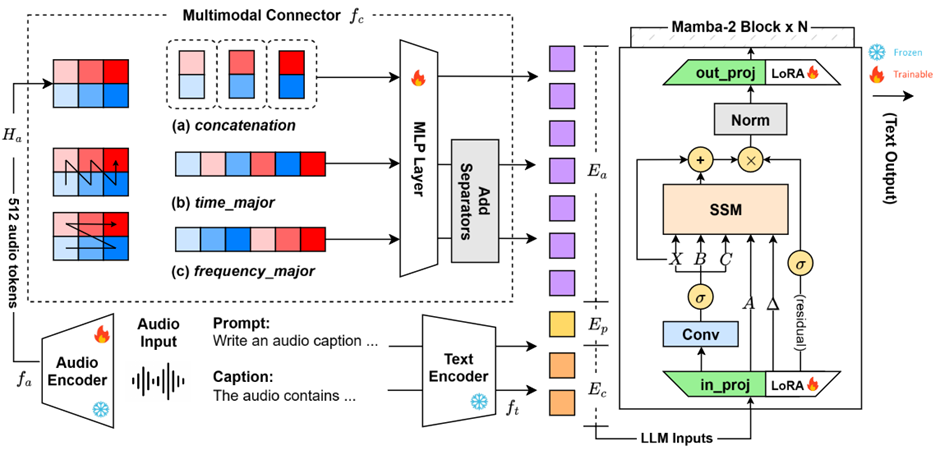
그림1. SSM 기반 Audio-language Model 구조도
연구팀은 State-Space Model (SSM) 기반의 새로운 오디오-언어 모델 ‘SAM(State-space Audio-language Model)’을 제안했다. SAM은 오디오 인코더와 Mamba-2 언어 모델을 결합한 오디오 추론을 수행하는 모델이다. 본 연구에서는 SAM-2.7B가 기존의 더 큰 7B급 Transformer 기반 오디오-언어 모델들과 비교하여 더 적은 파라미터로도 AudioSet, AudioCaps, MMAU 등 주요 벤치마크에서 우수한 성능을 달성하며 경쟁력 있는 성능을 보여주었다. 본 연구는 단순한 성능 비교를 넘어, SSM이 오디오 인코더의 출력 표현과 어떻게 상호작용하는지 분석했다. 그 결과, 오디오 인코더를 함께 학습하는 것이 중요하며, SSM에게 압축하지 않은 spectrogram의 긴 오디오 토큰 시퀀스를 그대로 사용하는 것보다 시간 단위로 압축된 더 짧은 토큰 시퀀스를 활용할 때 더 효과적이라는 점을 확인했다. 더불어 참/거짓 질의 및 객관식 질문 형태의 학습 데이터를 추가하면 오디오 추론 능력이 크게 향상되는 것도 보여주었다. 연구팀은 향후 SSM과 Transformer의 장점을 결합한 하이브리드 구조를 탐구해 오디오 추론 성능을 더욱 개선할 계획이다.
[참고자료]
논문링크: https://arxiv.org/abs/2509.15680
학회링크: https://interspeech2026.org/en-AU