

최우수국제학술대회 EMNLP 2026 Finding정규 발표 논문 채택
첨부파일

정재한 석사과정, 이태한 박사과정 (지도교수 이혁준 교수)
지능형 컴퓨터 아키텍처 및 임베디드 컴퓨팅 연구실(ECL) 석사과정 정재한(제1저자), 박사과정 이태한, 이혁준 교수(교신저자)의 논문 「RAMP: Regime-Aware Merge–Prune Token Compression for ASR-Oriented Audio-Language Models」이 EMNLP 2026 Findings에 채택되었다.
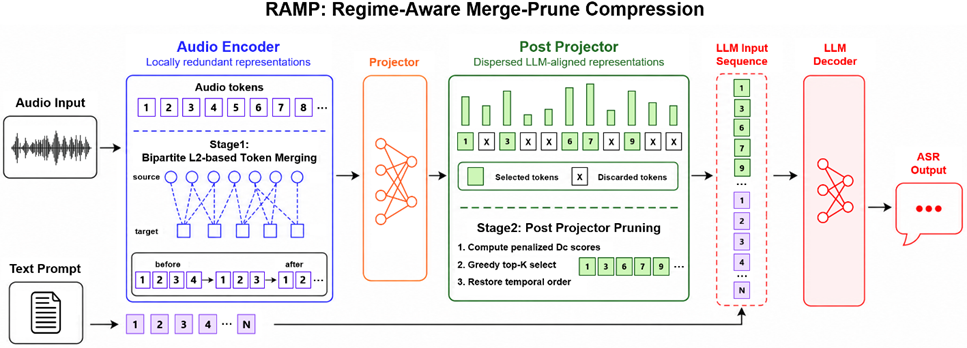
그림 1. RAMP의 오디오 토큰 압축 구조
최근 오디오-언어 모델(Audio-Language Model)은 음성을 긴 오디오 토큰 시퀀스로 변환하여 처리하기 때문에 높은 추론 비용이 발생한다. 연구팀은 모델 내부 표현을 분석한 결과, 오디오 인코더에서는 토큰 간 중복성이 높고, 프로젝터 이후에는 표현이 보다 분산되는 서로 다른 특성이 나타남을 확인하였다. 이를 바탕으로 인코더에서는 유사한 토큰을 병합하고, 프로젝터 이후에는 중요한 토큰을 선택적으로 보존하는 RAMP(Regime-Aware Merge–Prune)를 제안하였다. RAMP는 별도의 추가 학습 없이 적용할 수 있으며, attention map을 사용하지 않아 FlashAttention 기반 추론 환경과도 호환된다.
연구팀은 Audio-Flamingo-3와 Qwen2.5-Omni-7B를 대상으로 7개 음성인식 벤치마크에서 성능을 평가하였다. 특히 Audio-Flamingo-3에서 오디오 토큰을 40%만 유지하는 조건에서 평균 WER 배율이 2.36배로, 비교 기법의 4.26배보다 낮은 오류 증가를 보였으며, 기본 모델 대비 TTFT(Time-to-First-Token)를 24.8% 단축하였다. 이번 연구는 오디오-언어 모델의 단계별 표현 특성에 맞는 토큰 압축 방식을 통해 음성인식 성능 저하를 줄이면서 추론 효율을 향상시켰다는 점에서 의미가 있다.
[참고자료]
학회링크: https://2026.emnlp.org/